

从“生成”到“决策”:微软推出专用评分模型
当地时间10月9日,微软正式发布Microsoft-Decision-1,一款专为结构化决策任务设计的AI模型。微软CEO萨蒂亚·纳德拉在X平台上表示,该模型“在结构化决策任务上表现出色,在延迟和质量方面均优于大语言模型及其他决策模型”。
与ChatGPT等对话式大模型不同,Microsoft-Decision-1不生成文本,也不进行开放式推理。它的核心能力是从预设选项中选出最优答案,并为每个选项给出经过校准的概率评分。这些结构化输出可以被软件程序直接消费,无需人工介入。
微软Office of the CTO软件工程副总裁Achint Srivastava在声明中表示,决策评分系统代表了一个新兴的模型类别,旨在解决软件自动化中的延迟瓶颈问题。该模型的典型应用场景包括:对传入查询进行分类和路由、验证数据、评估AI响应质量,以及管理AI智能体工作流中的决策节点。
技术架构:基于Qwen3.5-9B的后训练
Microsoft-Decision-1的技术路线并非从零构建。据微软披露,该模型基于阿里巴巴开源的通义千问Qwen3.5-9B进行后训练,训练重点放在单次推理决策评分机制上,以实现超低延迟的决策输出。训练数据由公开数据集和微软团队生成的合成数据组成。
微软表示,未来将把这一模型迁移到其他底座之上,包括其自研的MAI系列模型和OpenAI的模型。这意味着当前的Qwen底座是一个起点,而非终点。
性能数据:36项基准测试准确率第一,速度是GPT-6 Sol的35倍
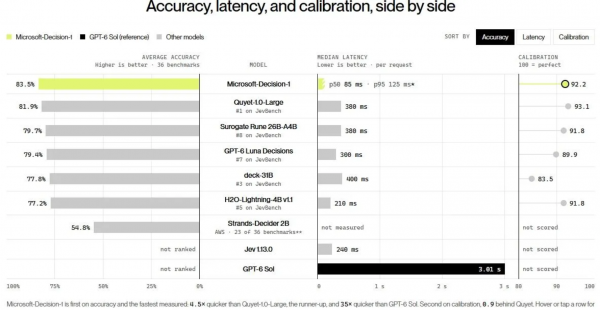
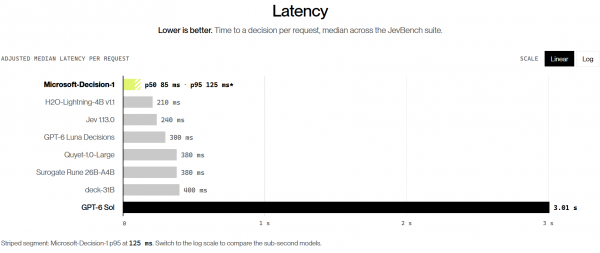
微软公布的数据显示,在覆盖36项基准测试、近15万个盲测问题的评测中,Microsoft-Decision-1取得了最高准确率。速度方面,其运行速度是GPT-6 Sol的约35倍,是排名次席的Quyet-1.0-Large的4.5倍。
该模型在稳定性上也表现出色。内部评估显示,当请求被改写或选项顺序被重新排列时,模型的决策输出仅在1.3%的情况下发生变化。在涵盖有害内容、越狱攻击和提示词注入的11项安全基准测试中,该模型在有效拦截恶意行为的同时保持了较高的可用性。
需要指出的是,上述性能数据均来自微软自身的基准测试,独立第三方验证尚未完成。
内部应用:Xbox分类1万条反馈,速度提升14倍
微软多个内部团队已经部署了该模型。Xbox Research团队使用Microsoft-Decision-1对超过1万条来自调查、Steam和X平台的玩家反馈进行主题分类,结果显示其质量与GPT-6 Sol相当,但速度提升超过14倍,成本降低约200倍。
微软Copilot团队则将这一模型用于交互式AI智能体响应的质量检查,在质量上与GPT-5.6 Luna表现相近的情况下,运行速度提升了最多100倍。纳德拉透露,该模型已在微软内部用于事故响应、质量控制及科学研究等场景测试。
定价与可用性
Microsoft-Decision-1即日起通过Microsoft Foundry向开发者开放,并计划后续接入OpenRouter。
定价方面,每百万输入token收费0.042美元(约合人民币0.28元),输出token免费。这一价格结构对高频、重复性的决策应用具有明显的成本吸引力。
战略意义:决策模型赛道竞争升温
Microsoft-Decision-1的发布,紧跟在OpenAI推出Decisions API公测版之后数日。继大语言模型和AI智能体之后,行业正在进入“决策模型”时代。这类模型的目标是快速高效地做出选择——比如判断该使用哪个AI模型,或者分析图像中有什么内容——而非生成流畅的文本。
微软此次发布的策略也体现了其AI产品线的“专用化”转向。在MAI系列自研模型覆盖推理、代码、图像、语音等多个方向之后,决策模型是微软在AI能力矩阵中填补的又一个空白。而选择基于开源Qwen模型进行后训练,而非完全从零构建,则反映出微软在模型开发上务实的一面:在追求性能的同时,控制成本、缩短周期。
对于开发者而言,Microsoft-Decision-1的实用价值在于,它提供了一种将AI决策能力嵌入现有软件工作流的低成本方式。当AI智能体需要在复杂环境中执行多步骤任务时,每一步决策的延迟都会累积。一个专门优化单次决策速度的模型,可能比一个通用大模型更适合这类场景。
(素材来自:微软 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。