

DeepMind发布EmbeddingGemma 2:把多模态搜索装进口袋
当地时间10月6日,谷歌DeepMind正式发布EmbeddingGemma 2,这是一款开源多模态嵌入模型,参数规模740M,能够在手机、笔记本和浏览器端离线运行。完整多模态模型内存占用不到600MB,全程无需将数据上传云端。
EmbeddingGemma 2是DeepMind首个原生多模态嵌入模型。与第一代仅支持文本不同,新版本将文字、代码、图片、视频帧和音频映射到同一个768维向量空间,支持跨模态检索。模型基于Gemma 4架构构建,采用模块化编码器设计:纯文本应用仅需约270M参数,视觉和音频编码器分别额外增加170M和300M参数,按需加载。在Pixel 11 Pro的量化测试中,纯文本权重活跃内存约191MB,完整多模态模型约567MB。
性能:代码检索大幅提升,多模态指标首次披露
根据谷歌公布的基准测试数据,EmbeddingGemma 2在MTEB代码检索任务上得分为78.68,较第一代的68.76提升近10分。MTEB多语言v2得分为61.36,较前代的61.15仅微增0.21分。谷歌解释称,多模态能力的扩展是本轮升级的重点,代码能力的提升则直接服务于编程智能体场景下的本地代码搜索需求。
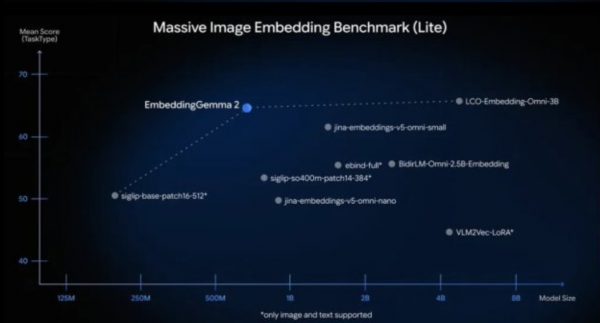
新版本首次披露了多模态基准数据:MIEB lite得分64.64,MMEB v2图像轨道两项分别得57.28和67.84,MMEB v2视频轨道得50.67,MSEB检索得69.54,MAEB得49.39。谷歌将这些数据描述为“在1B参数以下多模态嵌入模型中的领先水平”,并称在图像、视频和音频任务上,模型表现优于部分参数量超过其两倍的专用模型。
上下文窗口从上一代的2K扩展至8K,单次请求可处理最多5.5分钟音频、29张图片或58帧视频。语言覆盖超过100种。
许可变更:从审批到Apache 2.0
EmbeddingGemma 2在许可证上做出了一个关键调整。第一代模型采用Gemma使用条款,下载需要谷歌人工审批,谷歌称该版本已获得超过2000万次下载。新版本改为Apache 2.0许可证,且取消了下载门控,构建服务器可以自动拉取模型权重,无需人工介入。
授权已在Hugging Face和Kaggle开放,支持vLLM、llama.cpp和Ollama等开源服务工具。谷歌表示,Gemini Enterprise Agent Platform的Model Garden接入“即将上线”。
端侧应用:从意图路由到视频片段定位
EmbeddingGemma 2最突出的能力之一,是作为端侧超低延迟决策引擎。无需任何训练数据或微调,模型可以将用户输入直接与分类标签和描述进行匹配,在毫秒级完成零样本意图路由。
在Google AI Edge Gallery演示应用中,新增了“即时媒体搜索”和“视频片段查找器”两个功能。用户可以用自然语言或示例图片在本地相册中检索,查询和媒体在设备端转化为嵌入向量,存储于本地SQLite数据库,通过余弦相似度完成匹配。键入“Katze”(德语“猫”)时,结果会实时更新,全程无需联网。
(素材来自:谷歌DeepMind 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。