

在AI工厂的功耗墙上,光模块先撞了上去
当AI集群从数千颗GPU扩展到数十万颗,瓶颈不再只是芯片本身。连接这些芯片的网络,正在成为决定集群规模上限的关键约束。
问题的核心在于前面板带宽密度。一台交换机的物理空间是固定的,能插入的光模块数量有限。当单通道速率停留在200Gb/s时,要提升总带宽只能增加模块数量,而模块数量又受限于面板面积。当交换机容量用尽,进一步的网络扩展就需要增加交换层级和光链路,带来延迟、功耗和成本的同步攀升。
英伟达与思科在10月12日OCP全球峰会上公布的USFP,正是针对这一约束的回应。
USFP是什么:在熟悉的尺寸里做翻倍的事
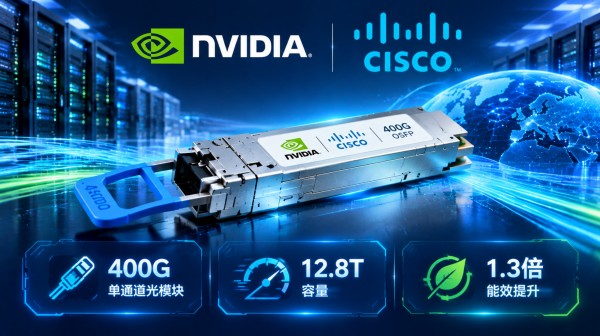
USFP全称Ultra-Dense Small Form Factor Pluggable,是一款面向AI工厂以太网的高密度可插拔光模块规格。它的核心目标是在不改变现有部署模式的前提下,将单通道速率从200Gb/s提升至400Gb/s。
首批规划的USFP收发器将在与现有OSFP模块相当的尺寸内,集成16条全双工通道,同时支持交换机和SuperNIC。这一设计的关键在于“双重翻倍”:通道数量翻倍,单通道带宽也翻倍。两个维度同时提升,使USFP的带宽密度达到现有200Gb/s单通道模块的四倍。如果扩展到32条通道,总容量可达12.8Tb/s。
能效方面,从200Gb/s提升到400Gb/s单通道,信号速率的提高本身会带来约1.5倍的功耗增长。但USFP通过架构优化,最终实现了约1.3倍于200Gb/s模块的能效。这意味着在传输每比特数据时,功耗反而更低。
技术实现:连接器与散热的双重挑战
高速电信号在连接器中的传输质量,是USFP面临的第一个工程挑战。为此,设计采用了二维连接器阵列和两步插入机制:模块先完成物理插入,高速电触点随后才接合。这一顺序减少了触点磨损,同时有助于在200Gb/s速率下维持信号质量。
散热是第二个挑战。USFP设计可在模块内部不依赖独立冷却回路的情况下,耗散最高100瓦的功率。这一能力简化了交换机构造,使更高带宽的光连接不必引入额外的散热复杂度。
生态策略:开放标准与多源供应
USFP的技术细节之外,更值得关注的是它的推进方式。
英伟达与思科正与TE Connectivity和Amphenol合作,围绕USFP构建多源硬件生态系统。该规格以开放的多源协议(MSA)形式推进,目标是让多家供应商能够生产兼容的模块。
这与当前光互连领域另一条主流路线——共封装光学(CPO)——形成了对照。CPO将光引擎与交换ASIC集成在同一基板上,可进一步降低时延和功耗,但封装成本较高,且光引擎出现故障时维护难度更大。博通是CPO路线的主要推动者之一。
英伟达与思科选择可插拔路线,保留了独立现场可更换模块的优势:成熟供应链、多供应商互操作性,以及数据中心运营商熟悉的运维模式。思科方面表示,USFP的设计目标是“在保持可插拔光学器件的可维护性、部署灵活性和运维简单性的同时,提供新的带宽密度水平”。
对AI工厂的实际意义
对于正在规划大规模AI集群的团队而言,USFP的影响体现在三个层面。
首先,同样的机架空间可以容纳更高的网络容量。在不增加交换层级的前提下,AI工厂可以连接更多的1.6Tb/s端点。这意味着网络拓扑可以保持更简洁,端到端延迟和运维复杂度相应降低。
其次,网络在AI工厂总功耗预算中的占比有望下降。在吉瓦级园区中,电力是最稀缺的资源之一。每比特数据传输功耗的降低,直接释放出可用于计算的功率余量。
第三,可插拔路线意味着现有的部署、维护和供应链模式可以延续。对于运营着数万台交换机的数据中心而言,不改变运维模式就能升级到下一代光互连,其价值可能不亚于技术指标本身的提升。
尚待验证的问题
USFP目前仍处于规格公布阶段,商业发布时间尚未披露。首批16通道产品何时送样、何时量产,将决定这项技术从蓝图走向机架的实际节奏。
英伟达与思科公布的能效和带宽密度数据均为厂商自身声明,独立第三方验证尚未完成。信号完整性在实际部署中的表现、不同供应商模块之间的互操作性、以及长期运行下的可靠性,都需要在实际部署中检验。
从200Gb/s到400Gb/s单通道的跃升,正在多个技术路线上同步推进。USFP能否成为AI工厂光互连的主流选择,取决于开放生态的落地速度,以及它在与CPO路线的竞争中能否证明可插拔方案在运维灵活性和总体拥有成本上的优势。
(素材来自:英伟达/思科 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。