

在2026年OCP全球峰会上,联想对外公布一项重要的商业化进展,正式开启英伟达Vera Rubin NVL72机架级AI系统的全球供货。整套Vera Rubin平台也被完整纳入联想AI云超级工厂解决方案当中,进一步补齐面向全球云服务商的AI基础设施交付能力。当下AI产业的需求,已经从零散硬件采购,转向完整AI算力工厂的整体搭建,这一方案也正是瞄准这一行业变化。
Vera Rubin平台带来算力指标大幅升级
Vera Rubin是英伟达专门为新一代AI训练、推理以及智能体计算打造的软硬件平台。其中NVL72作为核心系统,内部搭载72颗Rubin GPU搭配36颗Vera CPU,依靠NVLink6高速互连技术完成芯片之间的数据互通。
对比上一代产品,这套系统每兆瓦吞吐量最高提升30倍,每百万Token推理成本最多压缩至原有水平的1/45。在处理大型模型任务的时候,只需要前代四分之一数量的GPU,就能够输出同等水平的AI算力,硬件资源利用效率得到明显改善。
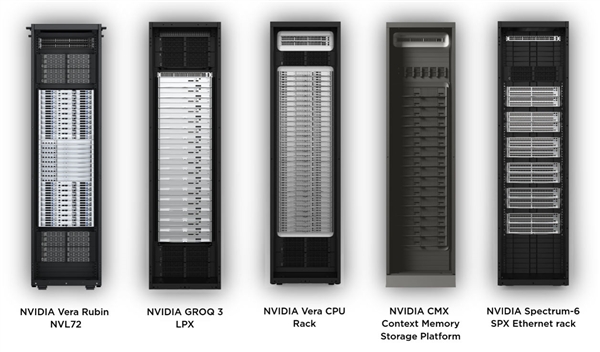
联想这次并没有单独输出算力机架,而是一次性整合五大机架级设备打包交付。整套组合包含Vera Rubin NVL72、Groq 3 LPX推理加速系统、Vera CPU机架、CMX上下文存储平台,还有Spectrum-6网络系统。计算、推理加速、存储、网络全部覆盖,客户拿到整套架构就可以搭建完整AI基础设施,目前NVL72已经正式面向全球出货。
全球化制造能力支撑大规模落地
想要把高性能AI硬件真正跑起来,强大的制造与交付体系是必不可少的底层条件。联想在全球11个市场布局超过30座生产工厂,同时还在扩建美国北卡罗来纳智能制造园区,整体制造产能提升35%,新增产能也覆盖直接液冷系统的生产制造。
除硬件生产之外,联想还配套提供灵活融资、按需使用的商业模式。对于云服务商来说,建设AI工厂前期资金投入巨大,这类模式能够有效缓解客户前期资金压力,降低AI基础设施上马的门槛。
行业视角:算力竞争逻辑已经发生改变
联想负责人Conor Malone在现场表达了自己对行业现状的判断,如今AI行业比拼,早已不是简单采购堆砌GPU。云服务商真正比拼的,是如何把电力、机房空间、硬件投入,快速转化成可以实际运行、能够产生收益的AI算力。
联想AI云超级工厂的思路,就是把英伟达的先进硬件平台,叠加联想全球制造、项目部署的实践经验,帮助客户缩短AI工厂建设周期,降低规模化扩张的风险,更早实现商业回报。
英伟达企业平台与解决方案副总裁Chris Marriott也提到,新一代AI云,需要适配复杂推理、智能体任务的全栈机架级基础设施。Vera Rubin平台融入联想AI云超级工厂之后,能够帮助云厂商简化部署流程,让前期的硬件投资更快转化为具备产出能力的算力资源。
现阶段NVL72已经实现全球发货,平台其余相关产品,会跟随生态成熟度逐步开放早期试用权限。整个AI行业的需求正在发生迁移,单纯采购芯片硬件的时代慢慢过去,液冷技术、全球化制造、系统集成、规模化交付这些综合能力,会成为基础设施厂商参与新一轮AI建设周期的核心竞争力。
(素材来自:联想 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。