

一只匿名“太空兔”走到台前
10月19日,MiniMax正式发布了M3.1 Flash。此前在OpenRouter和OpenCode上以“Space Bunny”名义匿名运行的模型,正是它的早期版本。据MiniMax披露,这只“兔子”在匿名期间处理了超过200 trillion tokens的调用量,一度登上两个平台的日调用榜首位。
官方发布时同步公开了完整的基准测试表和API定价,意味着此前只有跑分片段流传的模型,终于进入了可对比、可采购的阶段。
商业流程基准评分领先
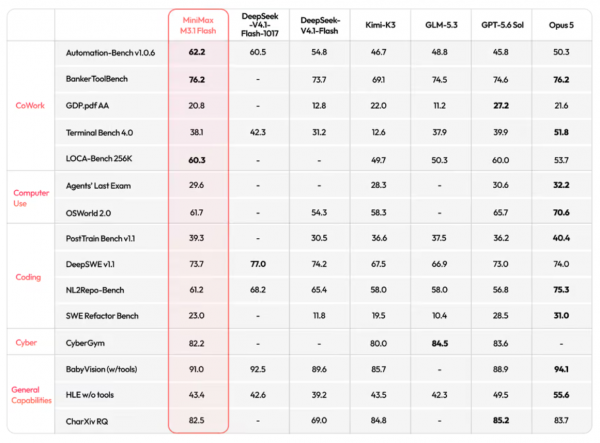
在企业自动化这条线上,M3.1 Flash交出的数字相当靠前。Automation-Bench v1.0.6涵盖销售、营销、运营、客服、财务和人力资源等跨SaaS系统的业务流程,共600个任务。M3.1 Flash取得62.2分,高于DeepSeek V4.1 Flash-1017的60.5分,也明显领先Claude Opus 5的50.3分和GPT-5.6 Sol的45.8分。在侧重多步骤规划与金融合规的BankerToolBench上,它拿到76.2分,与Opus 5持平;编程基准DeepSWE v1.1为73.7%,接近Opus 5的74.0%,略低于DeepSeek的77.0%。
独立评测机构Artificial Analysis给出的智能指数为42分,比前代M3的29分高出13分。完成一次指数任务的均摊成本从M3的约$0.51降到$0.22,降幅接近57%。作为对照,DeepSeek V4.1 Flash-1017的指数为45分、单任务约$0.26,GLM-5.3 Flash为42分、约$0.28。在复杂推理分项上,M3.1 Flash在Humanity‘s Last Exam中取得48%,高于DeepSeek的43%;物理推理基准CritPt为22%,低于DeepSeek的24%。
一个不能只看跑分的数字
但同一套独立评测也指向了一个企业在部署前无法绕过的指标。在AA-Omniscience事实知识测试中,M3.1 Flash的正确率为56%,高于DeepSeek的43%;然而Artificial Analysis同时记录到93%的幻觉率。这个数字的含义需要拆开理解:不是56%的正确率对应93%的“答错率”,而是模型在面对不确定的问题时,倾向于生成一个看似确定的答案,而不是明确表示“不知道”或拒绝作答。在测试统计中,凡是模型给出了回答但回答与事实不符的情形,都被计入幻觉一侧。
这种倾向在单轮问答里表现为“过度自信”,在多步骤智能体流程中则会被放大。一个每一步都有较高出错的概率,在一个由数十次调用组成的企业工作流里,误差会随着步骤数累积。M3.1 Flash在基准测试中的输出量也偏大:智能指数评估期间生成约180 million output tokens,中位数模型为99 million,说明它更倾向于“把答案说完”而非在不确定处停住。
低价背后的工程取舍
从规格看,M3.1 Flash是一个428 billion总参数、激活参数23 billion的MoE模型,支持文本、图像和视频输入,上下文窗口为1M tokens,API定价为每百万输入token $0.15、输出$0.60、缓存读取$0.015,与前代M3相比智能体任务综合成本下降约70%,推理速度提升近3倍。模型计划于10月23日以开源形式放出。
成本下降的一个重要来源是输出策略:模型倾向于用更长的输出去覆盖不确定性,这在定价上并不直接“便宜”,因为输出token是需要付费的;但在基准测试的均摊成本上,更低的任务单价和更快的吞吐量抵消了输出量的增加。对企业来说,真正要算的账不是每百万token的价格,而是“一次业务动作的总成本”,其中包含调用次数、输出长度,以及最容易被忽略的一项:对模型输出进行校验或兜底所需的额外环节。
对于输出会进入自动执行流程的场景,比如直接触发工单、写入数据库或生成对客回复,93%的幻觉率意味着模型自己几乎不设“刹车”。MiniMax官方将M3.1 Flash定位为Coding和Agent方向的轻量模型,在漏洞发现基准CyberGym上取得82%的分数,在电脑操作基准OSWorld 2.0上为61.7分。这些能力在有人监督、有校验层的流水线中可以发挥价值;但在要求模型主动识别自身知识边界的任务里,它的行为模式与“可靠”之间存在一段不小的距离。
(素材来自:MiniMax 智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。