

聊算力军备,绕不开一个最实在的问题:建一个GW,要花多少钱?这GW又能吐出多少token?把这两笔账放在一起,才能看清各家芯片平台的真实性价比。
一、每GW全口径造价:从380亿到600亿美元
先算投入。按芯片平台的每GW全口径造价,美国市场GB200时代约380亿美元,其中三分之二是IT设备;到下一代VeraRubin,这个数字跳到约600亿美元。NVIDIA自己披露的每GW收入,也水涨船高——从Hopper约180亿、Blackwell约250亿,升到Rubin约400亿美元。也就是说,算力平台越往高代际走,单GW造价里NVIDIA拿走的份额越大。
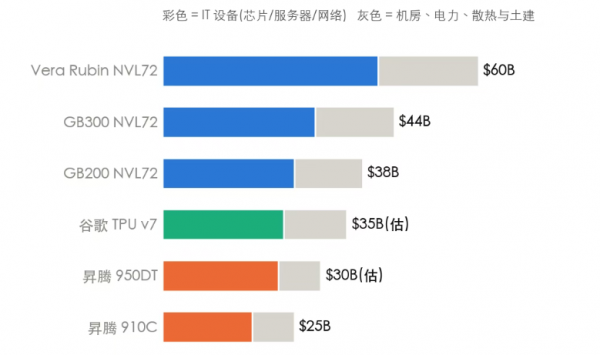
谷歌TPU路线更便宜。按成品机柜推算,TPUv7每GW约350亿美元;SemiAnalysis估计,其单芯片总持有成本比GB200低三到四成。国产昇腾每GW约250到300亿美元,便宜在芯片、电价和土建,但要清醒一点——每GW装下的绝对算力也更少。便宜是真便宜,密度差距也是真差距。
二、每GW每天产多少token:代际差距悬殊
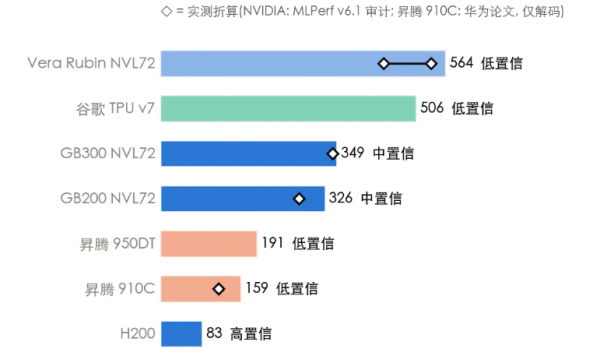
投入看完看产出。同一套工作负载下,一个GW每天的输出token:GB300约349万亿,VeraRubin约564万亿,而上一代H200只有83万亿。昇腾910C约159万亿,大约是GB200的一半。
这里有个细节值得注意:GB200和GB300的模型值,与MLPerfv6.1审计结果折算出来,差距不到两成;但VeraRubin的实测折算是442到535万亿,明显低于564万亿的模型值——也就是说,厂商宣传的数字偏乐观,真实落地要打个折。
更颠覆认知的是工作负载的杀伤力。同样是GB300,换成64k上下文的agent负载,每GW每天只剩约14.3万亿token,不到标准负载的二十分之一。这意味着,用短上下文压测出来的算力规模,到了长链路智能体场景会严重缩水。另外,每块GPU的提升也不等于每GW的提升:VeraRubin单卡比GB300快近一倍,但单卡功耗同步拉高,光速度提升不能直接换算成每GW收益。
三、真正的标尺:每十亿美元产多少token
把横轴设为每GW造价、纵轴设为每GW每天token,就能看出谁真划算。
按每十亿美元造价算,TPU最划算,每天约产出14.5万亿token;VeraRubin虽然每GW贵,但token产量也高,每美元产出约9.4万亿,反而高于GB300的7.9万亿。昇腾每美元产出约6.4万亿,跟国际一线的差距没有想象中大——真正的差距在每GW的绝对产出:同样一份token任务,中国要多用一倍左右的GW才能完成。
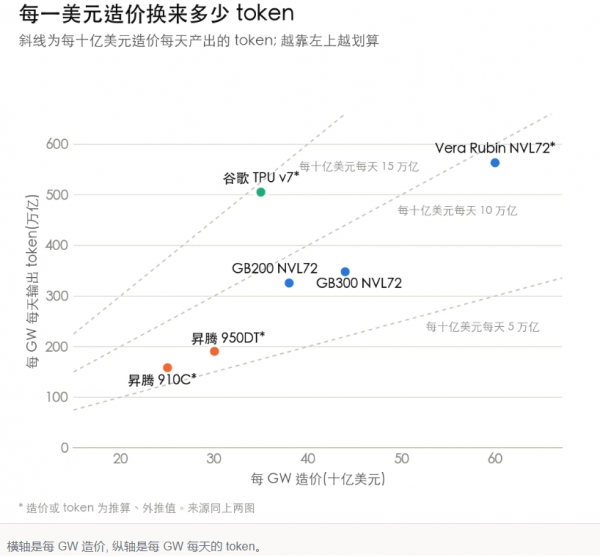
站在行业视角看,这组数据其实揭示了一个被"算力规模"叙事掩盖的真相:算力竞争的核心,正在从"建了多少GW"转向"每GW能产出多少有效token"。对云厂商和AI应用公司来说,盲目扩GW数量,如果单GWtoken产出上不去、工作负载又对不上,只会堆出大量闲置算力。TPU走自研、Vertical整合路线压成本,NVIDIA靠高代际溢价换token密度,昇腾用造价换规模,三条路背后是三种完全不同的商业逻辑。
往后看,评估一座算力中心的价值,不该再只看MW和GW装机,而要看"单位资本开支能吐出多少可计费token"。这把新标尺,会重新定义这轮算力军备竞赛的胜负手。
本文由智算芯能前沿网编辑整理,转载请注明出处。