

一块硅片的时代正在让位
过去半个世纪,CPU的基本形态是一整块硅片。服务器的供电、散热、主板布局和机架尺寸,很大程度上都是围绕这个前提展开的。
chiplet(模块计划小芯片技术)改变了这个前提:处理器不再从一整块大die上切出来,而是把计算、I/O、缓存和加速单元拆成多个较小的模块,封装在同一个基板上。这一变化看起来发生在芯片内部,但它向外传导的速度比想象中更快。
拆开的好处,先落在良率和灵活性上
把大芯片拆成小芯片,最直接的好处是制造端。小die的良率通常高于大面积单片die,一颗缺陷不会报废整块处理器;不同功能也可以按需组合,不必为了覆盖所有场景而设计一块面面俱到的大芯片。
更关键的是产品层面的弹性:同一套计算chiplet可以搭配不同的I/O die或加速die,覆盖从通用服务器到AI推理的不同档位。这种“按功能拆、按场景拼”的模式,正在成为服务器CPU的默认思路。
2026年的封装竞赛,给出了三个样本
Arm在Hot Chips 2026上公开的AGI CPU,用两个3nm计算chiplet拼出最高136个Neoverse V3核心,TDP控制在300W,片间通过UCIe互连。值得注意的是,AGI的两个chiplet各自带有计算、内存和I/O资源,而不是把I/O集中到一个中心die上;Arm选择这种近乎对称的拆分,部分原因是大面积单片die的制造成本和难度在上升。
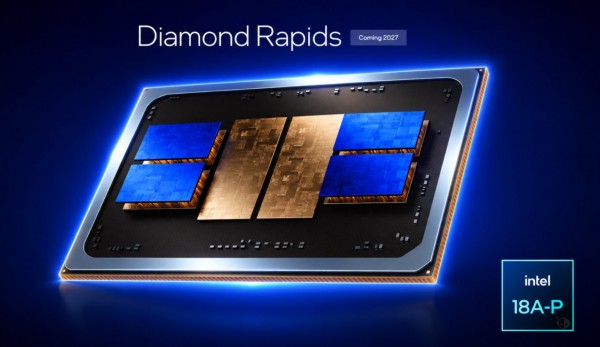
Intel的Diamond Rapids走了更分层的路线。它的封装内包含16个核心chiplet,每个16核,四个核心chiplet通过Foveros Direct 3D混合键合叠在一个基础tile上,共享320 MB L3缓存;基础tile再经由UCIe-S链路连接到Fabric Hub Tile,由后者承担内存控制器和系统级I/O。这种“3D堆叠加2D扇出”的组合,说明封装内部已经出现了类似片上网络的层级结构。
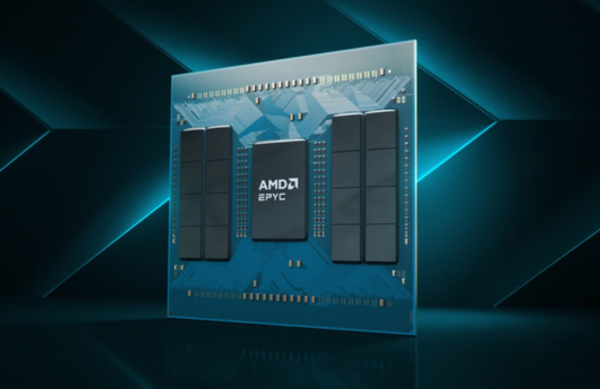
AMD的EPYC Venice则把计算chiplet推到2nm GAA工艺,最高256核,晶体管数量达到2030亿颗。台积电给出的工艺红利是:同功耗下性能提升10%至15%,同性能下功耗降低25%至30%。
Qualcomm的Dragonfly C1000同样采用多chiplet设计,核心数超过250,官方给出的每瓦性能对比数据超过竞品两倍,并计划在2028年进入商用。
互连标准把“拆得开”变成“拼得上”
chiplet能否成立,不取决于单个die做得多好,而取决于die与die之间的连接。UCIe 3.0将单通道数据率推到64 GT/s,GUC和Alphawave Semi先后在台积电3nm/N3P上完成64 Gbps UCIe IP的流片,带宽密度达到每毫米晶粒边缘21 Tbps(10.5 Tbps/mm全双工)。
对于服务器设计来说,这个数字的意义在于:chiplet之间的通信开销正在被压缩到足以让“拆分”不牺牲系统性能的程度。当互连带宽足够高、延迟足够低时,封装内多个die的组合在操作系统和虚拟化层看来,与一颗单片处理器之间的差异会越来越小。
对数据中心意味着什么:密度、功耗和规划节奏
数据中心最直接感受到的变化是计算密度。如果一颗封装内能容纳更多核心和更多专用加速单元,单台服务器在不扩大物理占地的条件下可以承载更重的负载。
另一个变量是功耗:chiplet让不同功能运行在各自更适合的工艺节点上,计算die追逐先进制程,I/O和模拟部分留在成熟节点,整体能效不必被最贵的那部分硅片绑架。
更长远的影响在基础设施规划层面。当处理器产品线以“chiplet组合”的形式快速衍生出不同核心数、不同缓存配置和不同加速能力的型号时,数据中心运营商面对的不再是少数几档固定的SKU,而是一组可以按机架功耗和散热能力来匹配的算力模块。这会改变采购节奏,也会改变机架级设计的假设条件。
瓶颈并没有消失,只是换了位置
chiplet把制造复杂度从“把一块die做大”转移到了“把多块die封好”。先进封装产能、已知良die的测试、封装内的热管理和供电,都会成为新的约束。
UCIe等标准降低了互连层面的不确定性,但封装本身的工程难度并不会因为标准存在而自动消失。
对数据中心而言,更务实的判断是:chiplet带来的密度和能效收益是真实的,但它把这些收益兑现的时间点,绑定在了封装供应链的爬坡节奏上。
(智算芯能前沿网综合)
本文由智算芯能前沿网编辑整理,转载请注明出处。